图遍历和搜索算法
2026-05-17
1. DFS 和 BFS
模板
DFS
#include <vector>
using namespace std;

constexpr int MAXN = 100005;

int n;
vector<int> adj[MAXN];
bool vis[MAXN];

void dfs(int u) {
    vis[u] = true;
    // previsit(u);
    for (int v : adj[u]) {
        if (!vis[v]) dfs(v);
    }
    // postvisit(u);
}

int main() {
    for (int i = 1; i <= n; ++i) {
        if (!vis[i]) dfs(i);
    }
}
BFS
#include <vector>
#include <queue>
using namespace std;

constexpr int MAXN = 100005;

int n;
vector<int> adj[MAXN];
bool vis[MAXN];

void bfs(int x) {
    queue<int> q;
    vis[x] = true;
    q.push(x);

    while (!q.empty()) {
        int u = q.front();
        q.pop();
        for (int v : adj[u]) {
            if (!vis[v]) {
                vis[v] = true;
                // visit(v);
                q.push(v);
            }
        }
    }
}

int main() {
    for (int i = 1; i <= n; ++i) {
        if (!vis[i]) bfs(i);
    }
}
分析
在无向图中,DFS 和 BFS 都可以遍历连通分量;在有向图中,它们可以用于遍历从某个起点可达的点集。如果只是需要遍历图,则 DFS 和 BFS 区别不大,可以混用。
DFS 的优势是可以用于寻找环,拓扑排序,强连通分量算法。
BFS 的优势是可以求无权图的单源最短路。
注:如果 DFS 爆栈,可以改为手写栈的 DFS
例 1(Luogu P3916)
给出
考虑计算每个点对
因此,反向建边并按节点编号从大到小 DFS 或 BFS
#include <iostream>
#include <vector>
using namespace std;

constexpr int MAXN = 100005;

vector<int> adj[MAXN];
bool vis[MAXN];
int A[MAXN];
int n, m;

void dfs(int u, int d) {
    vis[u] = true;
    A[u] = d;
    for (int v : adj[u]) {
        if (!vis[v]) dfs(v, d);
    }
}

int main() {
    cin >> n >> m;
    for (int i = 0; i < m; ++i) {
        int u, v;
        cin >> u >> v;
        adj[v].push_back(u);
    }
    for (int i = n; i >= 1; --i) {
        if (!vis[i]) dfs(i, i);
    }
    for (int i = 1; i <= n; i++) cout << A[i] << ' ';
}
时间复杂度为
2. 单源最短路
无权图
无权单源最短路用 BFS,核心代码如下:
#include <algorithm>

int n;
vector<int> adj[MAXN];
int dist[MAXN];

void bfs(int x) {
    fill(dist + 1, dist + n + 1, -1);
    queue<int> q;
    dist[x] = 0;
    q.push(x);

    while (!q.empty()) {
        int u = q.front();
        q.pop();
        for (int v : adj[u]) {
            if (dist[v] == -1) {
                dist[v] = dist[u] + 1;
                q.push(v);
            }
        }
    }
}
时间复杂度为
非负权图
非负权单源最短路用 dijkstra
由于 priority_queue 不支持 decreasekey 操作,可以在优先队列中存储一个点的多个副本,弹出时忽视垃圾值即可。
完整代码如下:
#include <iostream>
#include <vector>
#include <queue>
#include <functional>
#include <algorithm>
using namespace std;
using ll = long long;
struct edge {
    int v, w;
};

constexpr int MAXN = 100005;
constexpr ll INF = 4e18;

int n, m;
vector<edge> adj[MAXN];
ll dist[MAXN];

void dijkstra(int s) {
    fill(dist + 1, dist + n + 1, INF);

    priority_queue<pair<ll, int>, vector<pair<ll, int>>, greater<pair<ll, int>>> q;

    dist[s] = 0;
    q.push({0, s});

    while (!q.empty()) {
        auto [d, u] = q.top();
        q.pop();

        if (d != dist[u]) continue;

        for (auto [v, w] : adj[u]) {
            if (dist[v] > dist[u] + w) {
                dist[v] = dist[u] + w;
                q.push({dist[v], v});
            }
        }
    }
}

int main() {
    cin >> n >> m;
    for (int i = 0; i < m; ++i) {
        int u, v, w;
        cin >> u >> v >> w;
        adj[u].push_back({v, w});
        // adj[v].push_back({u, w});
    }

    dijkstra(1);
}
时间复杂度为
一般的图
对于存在负权的情况,最短路需要用 Bellman–Ford 算法。
#include <iostream>
#include <vector>
#include <algorithm>
using namespace std;

struct edge {
    int u, v, w;
};

constexpr int MAXN = 100005;
constexpr long long INF = 4e18;

int n, m;
vector<edge> edges;
long long dist[MAXN];

bool bellman_ford(int s) {
    fill(dist + 1, dist + n + 1, INF);

    dist[s] = 0;

    for (int i = 1; i <= n - 1; ++i) {
        bool updated = false;
        for (auto [u, v, w] : edges) {
            if (dist[u] == INF) continue;
            if (dist[v] > dist[u] + w) {
                dist[v] = dist[u] + w;
                updated = true;
            }
        }
        if (!updated) break;
    }

    for (auto [u, v, w] : edges) {
        if (dist[u] == INF) continue;
        if (dist[v] > dist[u] + w) {
            return false;
        }
    }

    return true;
}

int main() {
    cin >> n >> m;
    for (int i = 0; i < m; ++i) {
        int u, v, w;
        cin >> u >> v >> w;
        edges.push_back({u, v, w});
        // edges.push_back({v, u, w});
    }
    bool ok = bellman_ford(1);
}
时间复杂度为
0-1 BFS
如果边权只有
时间复杂度为
3. 差分约束
差分约束系统是一个不等式组,包含
每个约束条件
可以设一个哨兵节点
可能存在负权边,所以用 Bellman–Ford 算法。
注:等式约束可以拆成两个不等式约束。
4. DFS 搜索
现在开始搜索算法。
第一学期学习过 DFS 搜索算法。例如八皇后问题和数独问题 1784. T2(数独)
注:这里的 DFS 搜索算法和图上的 DFS 都使用了递归函数,但未必有直接联系。学习图论后,有时会倾向于从图的角度思考 DFS 搜索算法,但这可能没有任何帮助,反而会造成困惑。
在 DFS 搜索中,优化搜索顺序和剪枝非常重要。剪枝分为 可行性剪枝 和 最优性剪枝,在机考题 2923. 沙威玛传奇 中均涉及。这里再放一道 DFS 剪枝题。
例 2(Luogu P14377)
从小到大给定一组素数
的最大数
输入的第一行包含两个整数
第二行包含
容易想到 DFS 遍历满足目标形式的数。搜索树根节点上的数为
作为例子,
把
DFS 函数签名为 void dfs(int x, long long prod),prod 是调用栈上已经选择的素数的乘积,x 代表现在正在确定
实际代码中,每次循环让 prod *= p[x],然后调用 dfs(x - 1, prod)
直接跑这样的暴力搜索会 TLE,在调用 dfs(x - 1, prod) 前,需要做一个重要的最优性剪枝。
我们希望继续向下递归确实有希望更新 ans,但有些时候可以确定没有这个希望,此时就应该剪枝,下面推导这个条件:
将来在
如果 ans 不会被更新,因此,如果 ans 了,继续往下走都是无效分支,这等价于
由于
在 C++ 代码中,这就是 n/prod == ans/prod
#include <iostream>
using namespace std;

int k;
long long n;
int p[25];
long long ans = 1;

void dfs(int x, unsigned long long prod) {
    if (ans < prod) ans = prod;
    if (x == -1) return;
    while (true) {
        if (n / prod == ans / prod) return;
        dfs(x - 1, prod);
        if (prod > n / p[x]) break;
        prod *= p[x];
    }
}

int main() {
    cin >> k >> n;
    for (int i = 0; i < k; ++i) cin >> p[i];
    dfs(k - 1, 1);
    cout << ans;
}
按质数从大到小遍历,能在搜索图上更浅处快速增加 prod,更早触发剪枝,减少遍历的总节点数。按质数从小到大遍历也会导致 TLE
5. 最短路搜索
如果题目涉及最小步数,最少步骤,或最小代价,则可以考虑把问题抽象成一个图上的最短路问题。
每个需要遍历的状态对应图上的顶点,状态到状态的转移则对应图上的边,转移的代价是边权。
如果空间足够存所有顶点,那么可以用刚刚提到的最短路算法解决此类问题,包括 BFS, dijkstra, Bellman–Ford, 0-1 BFS 四种算法。
- 如果顶点是
这样连续的数,那么可以直接套用对应模板,用数组存储这些数。 - 如果顶点数量少,但范围大,那么考虑离散化或哈希(
unordered_map/unordered_set/手写哈希)。 - 如果顶点不是数,则考虑状态压缩,建立顶点到数的映射,转化为前两种情况。
例 3(Luogu P1135)
有
状态空间可以视为一个有向图,每个楼层是一个顶点。边
现在需要找到从
时间复杂度为
利用启发式函数剪枝
在此类问题中,常常有一个确定的目标点,此时就可以利用启发式函数剪枝。
假设需要找到从状态 A 到 状态 B 的最短路径。
如果任给一个状态 X,可以算出 X 至少需要
例 4(Luogu P2324 骑士精神)
在一个
给定一个初始的棋盘,怎样才能经过移动变成如下目标棋盘
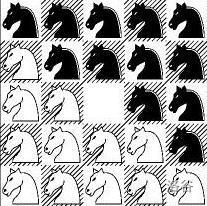
为了体现出骑士精神,他们必须以最小的步数完成任务。
如果能在 15 步以内(包括 15 步)到达目标状态,则输出步数,否则输出 -1
本题为多测,有
这就是典型的可以用启发式函数剪枝的例子。
对于当前状态下棋盘的每个骑士,如果它不在正确的位置上,就为估价函数贡献
由于题目要求:如果能在 15 步以内(包括 15 步)到达目标状态,则输出步数,否则输出 -1,那么可以对每个即将入队的状态计算启发式函数,如果
考虑状态如何压缩:用
状态空间大小为
6. DFS 和最短路
在某些情况下,即使已经用上了启发式函数剪枝,缩小了搜索的范围,空间仍然不够,那就必须放弃图上的最短路算法,使用 DFS
可以把图展开为搜索树。搜索树上的每一个顶点对应原图上的一个 walk,于是遍历搜索树相当于遍历原图上的 walk。当然,不得不遍历到重复的节点,浪费一些时间。
如果题目给出了类似 “保证存在
如果题目没有给出类似约束,但可以推导出一个较小的步数限制,那么就可以用它来限制搜索树。
如果题目没有给出约束,且无法推导出一个较小的步数限制,那么就需要迭代加深深度优先搜索(Iterative Deepening Depth-First Search, IDDFS),逐步加大深度限制。
深度限制常常配合启发式函数剪枝。使用了启发式函数剪枝的 IDDFS 被称为 IDA*( Iterative Deepening A*)
骑士精神的常见题解其实是 IDA* 而非刚刚的 BFS,IDA* 代码如下:
#include <iostream>
using namespace std;
constexpr int MAXD = 15;

int T;
int limit;
int tar[5][5] = {
    {1,1,1,1,1},
    {0,1,1,1,1},
    {0,0,2,1,1},
    {0,0,0,0,1},
    {0,0,0,0,0}
};
int st[5][5];
int dx[8] = {-2, -2, -1, -1, 1, 1, 2, 2};
int dy[8] = {-1, 1, -2, 2, -2, 2, -1, 1};

inline bool in_bound(int m, int n) {
    return 0 <= m && m <= 4 && 0 <= n && n <= 4;
}

bool dfs(int a, int b, int d, int error, int pre) {
    if (d + error - 1 > limit) return false;
    if (error == 0) return true;
    for (int i = 0; i < 8; ++i) {
        // 剪枝
        if (pre != -1 && i == (7 - pre)) continue;

        int nx = a + dx[i];
        int ny = b + dy[i];

        if (!in_bound(nx, ny)) continue;

        int knight = st[nx][ny];
        int new_error = error;
        if (knight == tar[a][b]) new_error--;
        if (knight == tar[nx][ny]) new_error++;

        swap(st[a][b], st[nx][ny]);
        if (dfs(nx, ny, d + 1, new_error, i)) return true;
        swap(st[a][b], st[nx][ny]);
    }
    return false;
}

void solve() {
    int u, v;
    for (int i = 0; i < 5; ++i) {
        for (int j = 0; j < 5; ++j) {
            char c;
            cin >> c;
            if (c == '*') {
                st[i][j] = 2;
                u = i, v = j;
            }
            else st[i][j] = c - '0';
        }
    }
    int error = 0;
    for (int i = 0; i < 5; ++i) {
        for (int j = 0; j < 5; ++j) {
            if (!(i == u && j == v)) error += (st[i][j] != tar[i][j]);
        }
    }
    if (error == 0) {
        cout << "0\n";
        return;
    }
    for (limit = 1; limit <= MAXD; ++limit) {
        if (dfs(u, v, 1, error, -1)) {
            cout << limit << '\n';
            return;
        }
    }
    cout << "-1\n";
}

int main() {
    cin >> T;
    for (int i = 0; i < T; ++i) solve();
}
当然,所有 IDDFS 和 IDA* 适用的地方,几乎都可以简单地用带有深度限制的 DFS 通过:
#include <iostream>
using namespace std;
constexpr int MAXD = 15;

int T;
int limit;
int tar[5][5] = {
    {1,1,1,1,1},
    {0,1,1,1,1},
    {0,0,2,1,1},
    {0,0,0,0,1},
    {0,0,0,0,0}
};
int st[5][5];
int dx[8] = {-2, -2, -1, -1, 1, 1, 2, 2};
int dy[8] = {-1, 1, -2, 2, -2, 2, -1, 1};
int ans;

inline bool in_bound(int m, int n) {
    return 0 <= m && m <= 4 && 0 <= n && n <= 4;
}

void dfs(int a, int b, int d, int error, int pre) {
    if (d + error - 1 > limit) return;
    if (error == 0) {
        limit = d - 2;
        ans = d - 1;
        return;
    }
    for (int i = 0; i < 8; ++i) {
        // 剪枝
        if (pre != -1 && i == (7 - pre)) continue;

        int nx = a + dx[i];
        int ny = b + dy[i];

        if (!in_bound(nx, ny)) continue;

        int knight = st[nx][ny];
        int new_error = error;
        if (knight != tar[nx][ny]) new_error--;
        if (knight != tar[a][b]) new_error++;

        swap(st[a][b], st[nx][ny]);
        dfs(nx, ny, d + 1, new_error, i);
        swap(st[a][b], st[nx][ny]);
    }
}

void solve() {
    int u, v;
    for (int i = 0; i < 5; ++i) {
        for (int j = 0; j < 5; ++j) {
            char c;
            cin >> c;
            if (c == '*') {
                st[i][j] = 2;
                u = i, v = j;
            }
            else st[i][j] = c - '0';
        }
    }
    int error = 0;
    for (int i = 0; i < 5; ++i) {
        for (int j = 0; j < 5; ++j) {
            if (!(i == 2 && j == 2)) error += (st[i][j] != tar[i][j]);
        }
    }
    if (error == 0) {
        cout << "0\n";
        return;
    }

    limit = MAXD;
    ans = -1;
    dfs(u, v, 1, error, -1);
    cout << ans << '\n';
}

int main() {
    cin >> T;
    for (int i = 0; i < T; ++i) solve();
}
7. 折半搜索
折半搜索,也称为 Meet in the middle 算法。思想是把搜索过程分成两半,然后合并结果
例 5(Luogu P11919)
一个底面尺寸为
求出有多少个本质不同的水箱满足以下条件:
; 。
定义两个水箱
自然的想法是枚举
#include <iostream>
#include <cmath>
using namespace std;

int n;
long long ans;

int main() {
    cin >> n;
    for (int a = 1; a <= n-1; ++a) {
        int t1 = n * n - a * a;
        for (int b = a; b * b <= t1; ++b) {
            int t2 = t1 - b * b;
            for (int h = 1; h * h <= t2; ++h) {
                int sum = a * a + b * b + h * h;
                int d = sqrt(sum);
                if (d * d == sum) ++ans;
            }
        }
    }
    cout << ans;
}
这个算法的时间复杂度是
考虑将问题转化为解整数方程
这就是
cnt 数组统计。
#include <iostream>
using namespace std;

int n;
long long ans;
constexpr int MAX = 25000005;
int cnt[MAX];

int main() {
    cin >> n;
    for (int a = 1; a <= n - 1; ++a) {
        int t1 = n*n - a*a;
        for (int b = a; b*b <= t1; ++b) {
            ++cnt[a*a + b*b];
        }
    }
    for (int k = 1; k <= n; ++k) {
        for (int h = 1; h <= k; ++h) {
            ans += cnt[k*k - h*h];
        }
    }
    cout << ans;
}
时间复杂度为
例 6(Luogu P9234)
小蓝正在一个瓜摊上买瓜。瓜摊上共有
小蓝希望买到的瓜的重量的和恰好为
请问小蓝至少要劈多少个瓜才能买到重量恰好为
每个瓜有买,不买,买一半三种状态,暴力搜索枚举买瓜情况的时间复杂度是
考虑折半搜索,将
由于 unordered_map
#include <iostream>
#include <algorithm>
#include <unordered_map>
#include <climits>
using namespace std;

int n;
long long m, a[31];
unordered_map<long long, int> mp;
int ans = INT_MAX;

void dfs1(long long sum, int x, int cnt) {
    if (sum > m || cnt > ans) return;
    if (sum == m) {
        if (ans > cnt) ans = cnt;
        return;
    }
    if (!(mp.count(sum) && mp[sum] < cnt)) mp[sum] = cnt;
    if (x > n/2) return;
    dfs1(sum, x+1, cnt);
    dfs1(sum+a[x]*2, x+1, cnt);
    dfs1(sum+a[x], x+1, cnt+1);
}

void dfs2(long long sum, int x, int cnt) {
    if (sum > m || cnt > ans) return;
    if (mp.count(m-sum) && ans > cnt+mp[m-sum]) ans = cnt+mp[m-sum];
    if (x > n) return;
    dfs2(sum, x+1, cnt);
    dfs2(sum+a[x]*2, x+1, cnt);
    dfs2(sum+a[x], x+1, cnt+1);
}
int main() {
    cin >> n >> m;
    m *= 2;
    for (int i = 1; i <= n; ++i) cin >> a[i];
    mp[0] = 0;
    dfs1(0,1,0);
    dfs2(0,n/2 + 1,0);
    cout << (ans > INT_MAX/2 ? -1 : ans);
}
但这不能 AC。经测试,如果要通过题面数据范围内的所有数据点,必须使用手写哈希,它在时间和空间上都比 unordered_map 更优秀。
注:洛谷上所有没有手写哈希的题解都可以被 hack 掉,只是恰巧能过原题数据点。只有 P9234 [蓝桥杯 2023 省 A] 买瓜 题解 这份手写哈希的题解能稳定通过 hack
8. A* 算法
在非负权图中,要求 A 到 B 的最短路径,若直接使用 dijkstra 算法,可以作如下分析:
的顶点必然被探索 的顶点可能被探索 的顶点不可能被探索
最坏情况下会探索所有
A* 算法利用启发式函数改进 dijkstra 算法。
在 dijkstra 中,每一步取出堆中
如果
如果还有
注:一致性加上
对于可采纳且一致的情况,可以对 A* 作如下分析:
的顶点必然被探索 的顶点可能被探索 的顶点不可能被探索
最坏情况下会探索所有
这比 dijkstra 能做到的更好,
评论区
最新评论
--